ทฤษฎีที่เกี่ยวข้อง
การรักษาคุณภาพโค้ดด้วย Linter
เนื่องจากการทำงานย่อมต้องมีมาตรฐาน หรือกฎที่กำหนดใช้ร่วมกัน รวมไปถึงการเขียนโปรแกรมอย่างมีมาตรฐานด้วย ซึ่งแต่ละทีมก็จะมีการตกลงมาตรฐานดังกล่าวที่แตกต่างกันไป แต่การที่โปรแกรมเมอร์จะสามารถคำนึงถึงมาตรฐานดังกล่าวตลอดเวลาที่เขียนโปรแกรมนั้นเป็นเรื่องที่ยาก รวมไปถึงถ้าหากเขียนโค้ดไปจำนวนมากแล้ว การจะกลับมาแก้โค้ดทั้งหมดให้ผ่านมาตรฐานของทีมก็เป็นงานที่เหนื่อยและลำบากพอสมควร จึงมีเครื่องมือที่ชื่อว่า Linter ขึ้นมา
ซึ่ง Linter จะทำการกำหนดมาตรฐานของโค้ดไว้ และสามารถเรียกใช้เพื่อตรวจโค้ดทั้งหมดในโปรเจ็กต์ได้ ว่ามีส่วนไหนที่ผิดจากรูปแบบที่กำหนดหรือไม่ ตัวอย่างเช่น
const f = function(res) {
  // do something
};
แต่ทางทีมต้องการใช้ arrow function ในทุกๆที่ ตัว Linter ก็จะบังคับให้เขียนในรูปแบบด้านล่างนี้ มิเช่นนั้นจะแจ้ง Error
const f = (res) => {
  // do something
};
ซึ่งนอกจากการที่ต้องมาเรียกใช้ผ่าน Command line เองแล้ว Editor บางตัวก็ยังมี Plugin สำหรับตรวจ Lint ในระหว่างที่กำลังโค้ดอยู่ด้วย เช่น Atom ก็มี Plugin linter-eslint ให้ใช้งาน ทำให้การโค้ดสะดวกสบายมากยิ่งขึ้น
Optimizing Webpack
- http://www.slideshare.net/trueter/how-to-make-your-webpack-builds-10x-faster
- http://stackoverflow.com/questions/38939274/babel-loader-cachedirectory-unknown-option
- https://github.com/amireh/happypack
เทคนิคการทำให้ Webpack เร็วขึ้นที่ได้ทดลองใช้คือ
- ใช้ Happypack
- การเปลี่ยนประเภทของ Source map
- การ Build ตัว modules ข้างนอกต่างๆก่อน
- ใช้ HardSourceWebpackPlugin
การทำงานของ Happypack
Happypack ช่วยเหลือในการทำ Cache ไฟล์ที่ไม่เปลี่ยนแปลง โดยจะนำไฟล์เหล่านั้นมาใช้ในการ Build ครั้งต่อไปโดยไม่จำเป็นต้องโหลดไฟล์ใหม่ ทำให้การ Build ถัดจากครั้งแรกเร็วขึ้นอย่างเห็นได้ชัด
ดังที่เห็นในหัวข้อลักษณะงานที่ปฏิบัติ ข้อ 2.6 ที่เวลาในการ Build ลดลงนับสิบเท่าในการ Build ครั้งถัดมา หรือรูปที่ 3-3 และ 3-4
รวมทั้ง Happypack เองก็จะ Build แบบ Parallel โดยเปิด Thread เพิ่มเติมมาช่วยในการ Build ทำให้เร็วยิ่งขึ้นไปอีก
การทำ Source map
ในการตั้งค่า Webpack ให้กับโปรเจ็กต์นั้น มีค่าหนึ่งคือค่า devtool ที่จะระบุวิธีการทำ Source map ของการ Build โดยที่มีหลายระดับ และแต่ละระดับก็จะมีความเร็วในการ Build ที่แตกต่างกันไป ซึ่งยิ่งความเร็วในการ Build มาก Readability ก็ยิ่งน้อยลงตาม ซึ่งเป็นเรื่องการ Trade-off ที่ต้องชั่งน้ำหนักดู
โดยแบบที่อ่านออกมากที่สุดคือ source-map ซึ่งขอยกตัวอย่างโค้ดส่วนหนึ่ง รวมทั้งเวลาที่ใช้ในการทำ Hot Module Replacement หากมีการแก้โค้ดมาดังนี้
// Component
<div className="text-center">
  <img className={classes.header} src="/images/logo.png" />
</div>

// Function
handleSubmit(e) {
  e.preventDefault();
  this.handleLogin();
}

รูปที่ 3-1 เวลาที่ใช้ในการทำ HMR ของ devtool แบบ source-map
ซึ่งโค้ดข้างต้นที่เห็นนั้น คือโค้ดที่ตรงกับโค้ดที่โปรแกรมเมอร์เขียน ซึ่งก็คือตัว Build จะทำการ Map โค้ดหลังจาก Compiled กลับให้ว่าโค้ดต้นแบบหน้าตาเป็นอย่างไร แต่ก็ใช้เวลาไปไม่น้อย คือ 13306 milliseconds
ในทางกลับกัน Source map ที่ทางทีมใช้อยู่ปัจจุบันคือแบบ eval ซึ่งจะ map กับเพียงแค่ Module เท่านั้น และเป็นตัวที่ Compiled แล้ว แต่ก็ใช้เวลาน้อยกว่า ดังที่ยกตัวอย่างต่อไปนี้ ซึ่งโค้ดทั้งสองส่วนที่ยกตัวอย่างมานั้น เป็นโค้ดชุดเดียวกับด้านบน
// Component
_base.React.createElement(
  'div',
  { className: 'text-center' },
  _base.React.createElement('img', { className: _Login2.default.header, src: '/images/logo.png' })
)

// Function
{
  key: 'handleSubmit',
  value: function handleSubmit(e) {
    e.preventDefault();
    this.handleLogin();
  }
}

รูปที่ 3-2 เวลาที่ใช้ในการทำ HMR ของ devtool แบบ eval
จะเห็นได้ว่าโค้ดแบบ source-map นั้นอ่านง่ายกว่ามาก แต่ก็ใช้เวลาในการทำ HMR สูงเช่นกัน ซึ่งเวลาต่างกับแบบ eval ประมาณ 8 วินาที โดยเวลาเท่านี้นั้นในระหว่างการพัฒนาแอพพลิเคชั่นนับว่าสูงมาก เพราะแก้โค้ดทีหนึ่ง ก็ต้องรอให้ HMR ทำงานถึงจะเห็นผลบน Browser ที่กำลังทดสอบอยู่ ดังนั้นการลดเวลาตรงนี้ถือว่าสำคัญต่อความลื่นไหลในการทำงาน ไม่ให้สะดุดรอ จึงมีหลายกรณี(รวมถึงกรณีของทีมข้าพเจ้า) ที่ยอมเสีย Readability ไปบ้าง เพื่อให้สามารถพัฒนาได้อย่างรวดเร็วและลื่นไหลขึ้น
การ Build ตัว Module ภายนอกแยกกับ Module ที่เขียนเอง
โดยปกติแล้ว Webpack จะ Build ใหม่ทุกครั้ง ซึ่งทำให้เสียเวลา ดังนั้นจึงมีแนวคิดขึ้นมาว่า ให้ Build ตัวที่น่าจะไม่ได้เปลี่ยนบ่อยๆก่อน หรือก็คือ Module ของภายนอกที่นำมาใช้ (เช่นมาจากการ npm install) โดย Build ไว้ก่อนรอบหนึ่ง แล้วเมื่อต้องการทำงานจริง ก็ค่อย Build ตัวที่จะเปลี่ยนบ่อยๆระหว่างการพัฒนา โดยต้องจัดการให้ตัวโปรเจ็กต์ไปอ่านไฟล์ที่ Build เสร็จก่อนหน้านี้มาใช้ (ที่มา: https://github.com/erikras/react-redux-universal-hot-example/issues/616#issuecomment-228956242)
การทำงานของ HardSourceWebpackPlugin
ใช้เพื่อช่วยในการ Cache Modules ในการรันครั้งแรกจะช้า แต่หลังจากที่ Cache ไว้แล้วจะให้ผลดีในเรื่องของความเร็วในการ Build มาก (ที่มา: https://github.com/mzgoddard/hard-source-webpack-plugin)
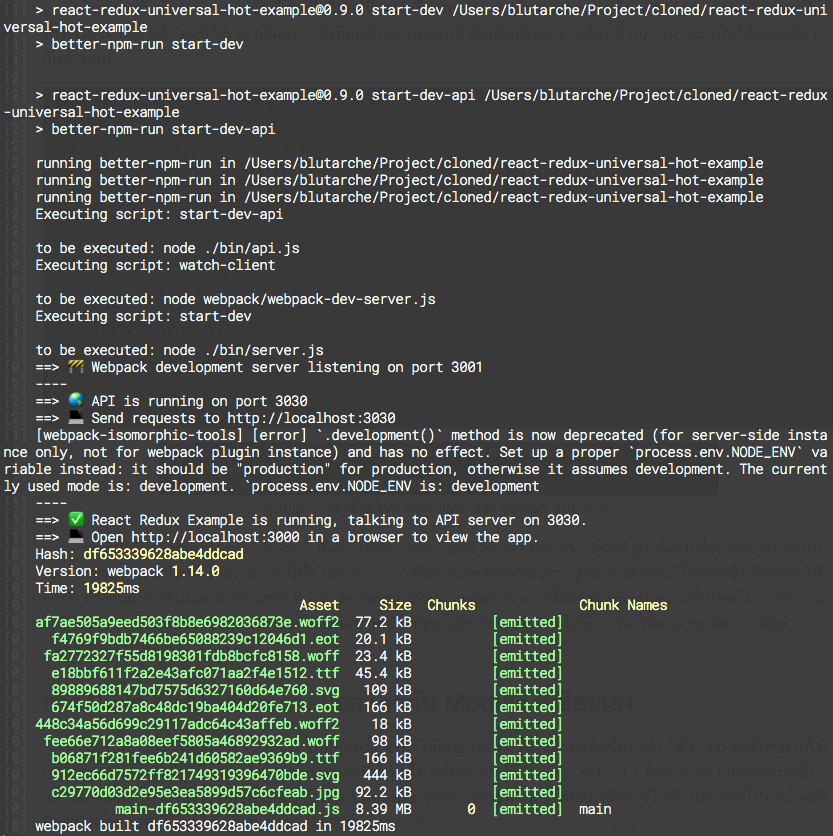
รูปที่ 3-3 เวลาที่ใช้ในการ Build แบบก่อนปรับแต่ง
ซึ่งก่อนปรับแต่งนั้น การ Build ทุกครั้งก็ต้องใช้เวลานานระดับหนึ่ง (ในที่นี้คือ 19825 milliseconds)
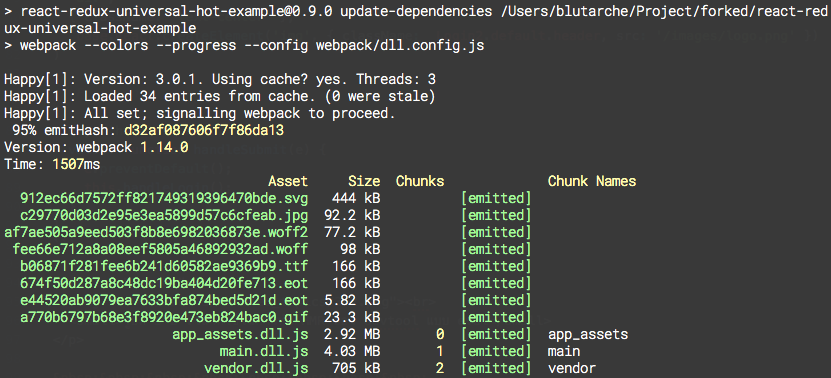
รูปที่ 3-4 เวลาที่ใช้ในการ Build Module ภายนอกหลังปรับแต่ง
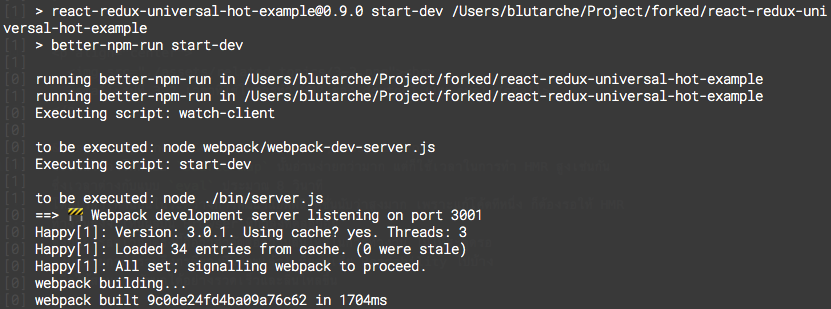
รูปที่ 3-5 เวลาที่ใช้ในการ Build Module ภายในหลังปรับแต่ง
ซึ่งหลังปรับแต่งนั้น ทุกครั้งที่มีการเปลี่ยน Module ภายนอกจะใช้เวลาในการ Build ใหม่ 1507 milliseconds (ทั้งนี้นี่คือการผ่าน cache แล้ว ถ้าหากไม่มี cache ก็จะใช้เวลาใกล้เคียงกับก่อนปรับแต่ง) แต่หลังจากนั้นจะใช้เวลาน้อยมากในการ Build Module ภายใน
โดยธรรมชาติของการพัฒนาแอพพลิเคชั่นนั้น การเปลี่ยน Module ภายนอกที่ใช้ไม่ได้เกิดขึ้นบ่อยนัก ดังนั้นการ Optimize แบบนี้จึงส่งผลมาก และช่วยให้การพัฒนาแอพพลิเคชั่นเป็นไปได้อย่างราบรื่นมากขึ้น
Continuous Integration (CI)
เพื่อให้การทำงานเป็นไปอย่างราบรื่น Build -> Test -> Deploy การทำงานคือหาก push โค้ดขึ้นไปบน github หรือ gitlab ผ่าน จะมีการ Setup CI ให้รัน Test Case หากรันผ่านก็จะรัน Script สำหรับ Deploy เองอัตโนมัติไปยัง Development Server แต่ถ้าไม่ผ่านจะแจ้งมายัง Slack ที่ใช้สื่อสารกันในบริษัท ซึ่งจะเป็นประโยชน์ในการทำงานเป็นทีม และ รวมถึง Flow ในการใช้ Git ร่วมกันด้วย
โดยใน github สามารถใช้งานร่วมกับ CircleCI แต่ gitlab จะมี CI ติดมาด้วยกันอยู่แล้ว
นอกจาก CircleCI ยังมี TravisCI, AppVeyor และอื่นๆอีกมากมาย
https://github.com/integrations/feature/continuous-integration
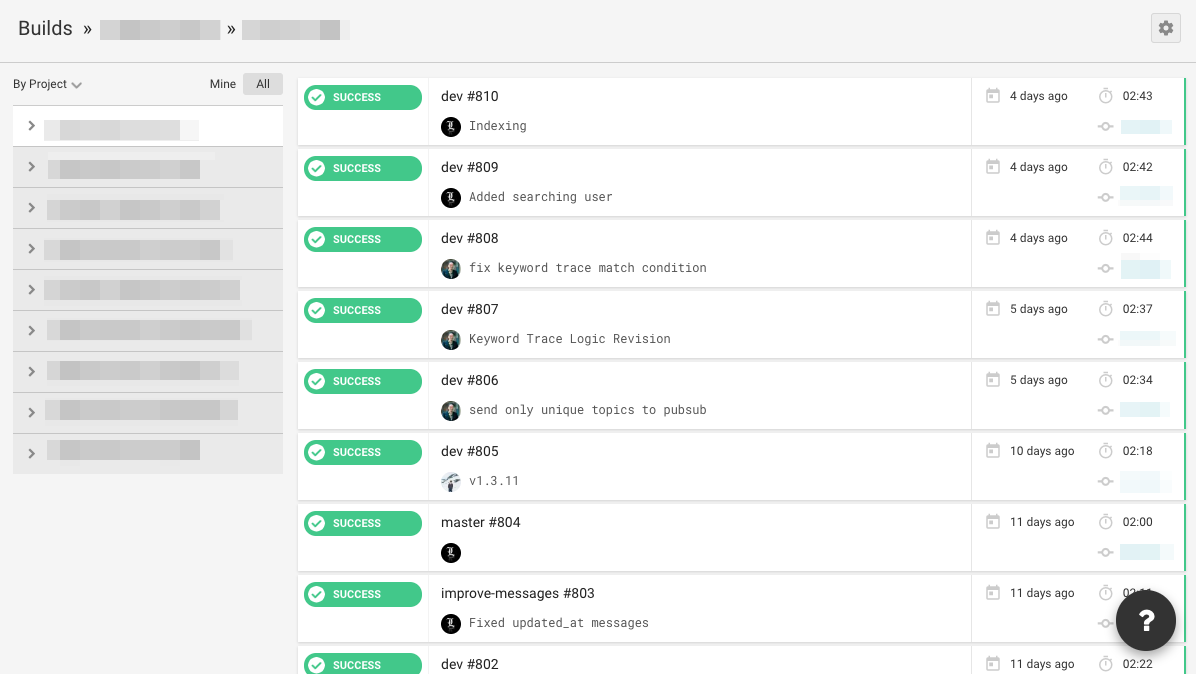
รูปที่ 3-6 หน้า Dashboard ของ CircleCI
Google Cloud Platform
ใช้ในโปรเจกต์ Social Monitoring โดย Service ที่นำมาใช้ ได้แก่
Google App EngineGoogle Compute EngineGoogle BigQueryGoogle Datastore
Google App Engine
เป็น PaaS (Platform as a Service) ข้อดีคือมีการ Auto Scaling และ สามารถตั้งค่าต่างๆได้ง่าย ผ่านไฟล์ .yaml นำมาใช้ Deploy Code ของโปรเจ็กต์ Social Monitoring สำหรับ Production
ตัวอย่างการตั้งค่า .yaml
management-service.yaml
runtime: node
vm: true

skip_files:
  - ^(.*/)?.*/node_modules/.*$

service: management-service

env_variables:
  SERVICE_NAME: 'management-service'

automatic_scaling:
  min_num_instances: 1
  max_num_instances: 3
  cool_down_period_sec: 300
  cpu_utilization:
    target_utilization: 0.5
กรณีต้องการใช้งานร่วมกับ pm2
- เปลี่ยนการตั้งค่า
runtime nodeเป็นruntime custom - สร้างไฟล์
Dockerfile - สร้างไฟล์
.dockerignore
Dockerfile
FROM gcr.io/google_appengine/nodejs
RUN /usr/local/bin/install_node '~6.4'
COPY . /app/
RUN npm install -g yarn
RUN yarn
RUN yarn global add pm2
CMD pm2-docker start ./build/bin/server.js -i 0
เมื่อรัน Command ด้านล่างนี้ จะทำงานโดยเริ่มต้นจากการที่นำโค้ดมา Build Docker Container และ ส่งไป Deploy ที่ Google App Engine
gcloud -q app deploy filename.yaml --promote --version=1
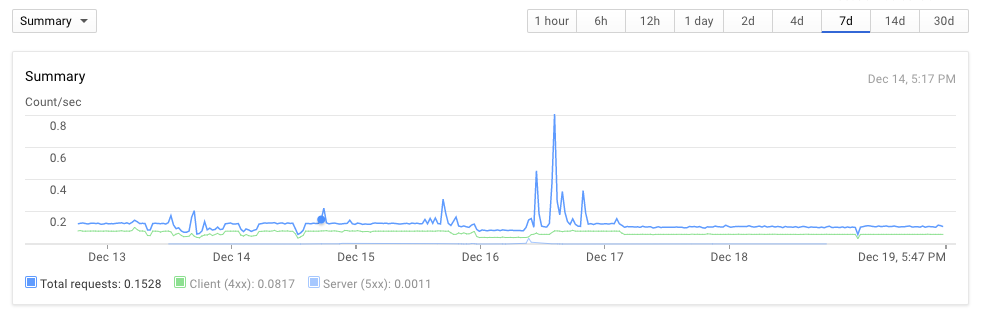
รูปที่ 3-7 กราฟการใช้งานของ Google App Engine
Google Compute Engine
ใช้งานเหมือน VPS ทั่วไป สามารถ SSH เข้าไปทำการตั้งค่าต่างๆได้ นำมาใช้งานในโปรเจกต์ Social Monitoring ในการนำ Code ใน branch dev ไป Deploy เองอัตโนมัติผ่าน CircleCI เพื่อให้สามารถส่งให้ลูกค้าทดสอบได้อย่างเป็นปัจุบัน
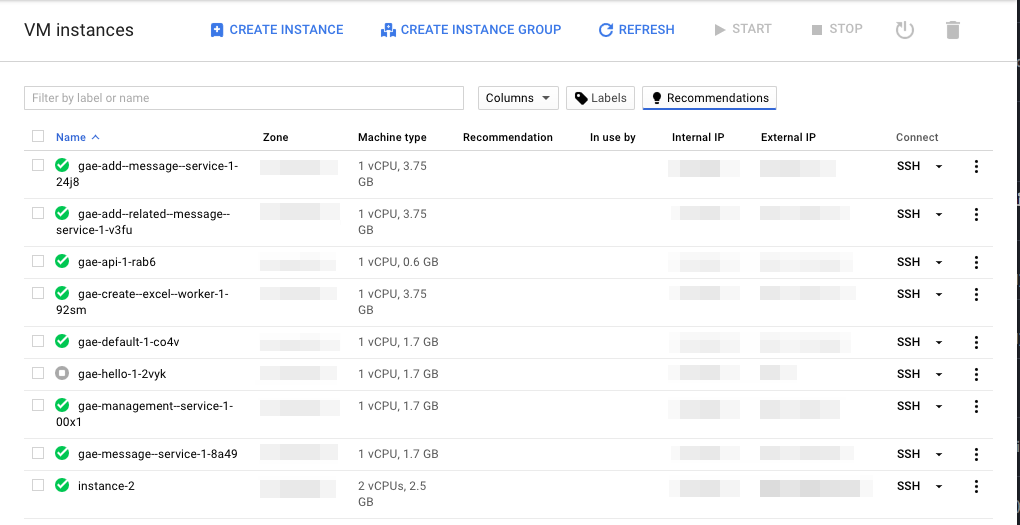 รูปที่ 3-8 Screenshot หน้า Instances ต่างๆ ของ Google Compute Engine
Google BigQuery
ใช้งานคล้ายๆ SQL แต่มีหลายคำสั่งและการลักษณะเก็บข้อมูลแตกต่างกัน สามารถ Query ข้อมูลปริมาณมาก และ คำสั่งซับซ้อนได้ในเวลาไม่กี่วินาที มีการคิดราคาตามที่ใช้งาน โดยคิดจาก ปริมาณข้อมูลที่ต้องค้นหา และ ปริมาณข้อมูลที่นำออกมา นอกจากนี้ยังสามารถใช้งานได้กับ Node.js (https://googlecloudplatform.github.io/google-cloud-node/#/docs/bigquery/0.6.0/bigquery)
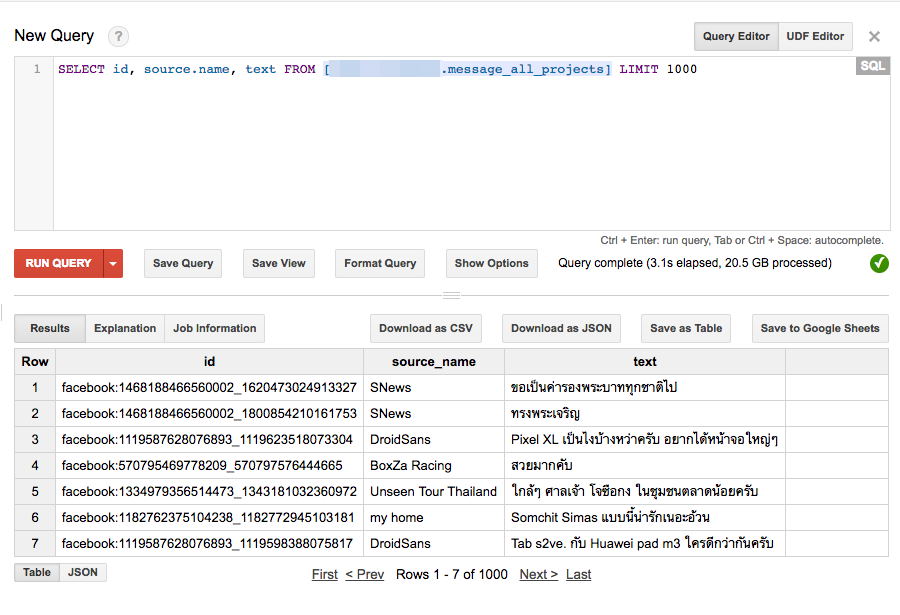
รูปที่ 3-9 Screenshot หน้า Google BigQuery
ข้อจำกัดของ BigQuery คือไม่สามารถเปลี่ยนแปลงข้อมูลที่เก็บลงไปแล้วได้ นิยมใช้งานในรูปแบบการเก็บ Log มาวิเคราะห์ แต่หากว่า Log มากเกินไป ก็จะแบ่งตารางตามช่วงเวลาที่เรียกว่า time-partitioned เพื่อให้ลดค่าใช้จ่าย และ ปริมาณข้อมูลลงในการ Query (ที่มา: https://cloud.google.com/bigquery/docs/partitioned-tables)
สำหรับ BigQuery จะมี Type Record เก็บได้หลาย Field ซึ่งทำให้มีการใช้งานในรูปแบบของ Nested Data สามารถเก็บแบบ หลาย Record ใน 1 Column ได้ (ที่มา: https://cloud.google.com/bigquery/data-types)
วิธีการจัดการกับ Nested และ Repeated Fields ใช้ Flatten กับ Field ที่เป็น Record ผลลัพธ์ที่ได้จะเหมือนผลคูณคาร์ทีเชียน สำหรับ Repeated Fields (ที่มา: https://cloud.google.com/bigquery/docs/data)
หากต้องการ Copy Table ที่มีขนาดใหญ่ ต้องใส่ allowLargeResults ด้วยจึงจะใช้งานได้โดยไม่มี Error เกิดขึ้น
(https://cloud.google.com/bigquery/docs/reference/rest/v2/jobs#configuration.query.allowLargeResults)
const queryConfig = {
  destination: destinationTable,
  query: queryCommands,
  allowLargeResults: true
};

bigquery.startQuery(queryConfig, callback);
การสร้าง View เพื่อใช้งานร่วมกับ Tableau (https://cloud.google.com/bigquery/docs/reference/rest/v2/tables#resource)
const options = {
  view: {
    query: queryCommands
  }
};
table.create(options, callback);
Google Datastore
Cloud Datastore is a highly-scalable NoSQL database for your web and mobile applications
เป็น NoSQL Document Database เก็บในรูปแบบ key และ value ข้อดีคือ สามารถใช้งานได้โดยไม่ต้องห่วงเรื่องการ Scale Database
เขียนและอ่านได้อย่างรวดเร็ว ข้อเสียคือ การ Query ทำได้ค่อนข้างจำกัด ไม่สามารถใช้การ or ได้ (Operator ในการ Filter ที่ใช้ได้มีแค่ =, <=, <, >, >=)
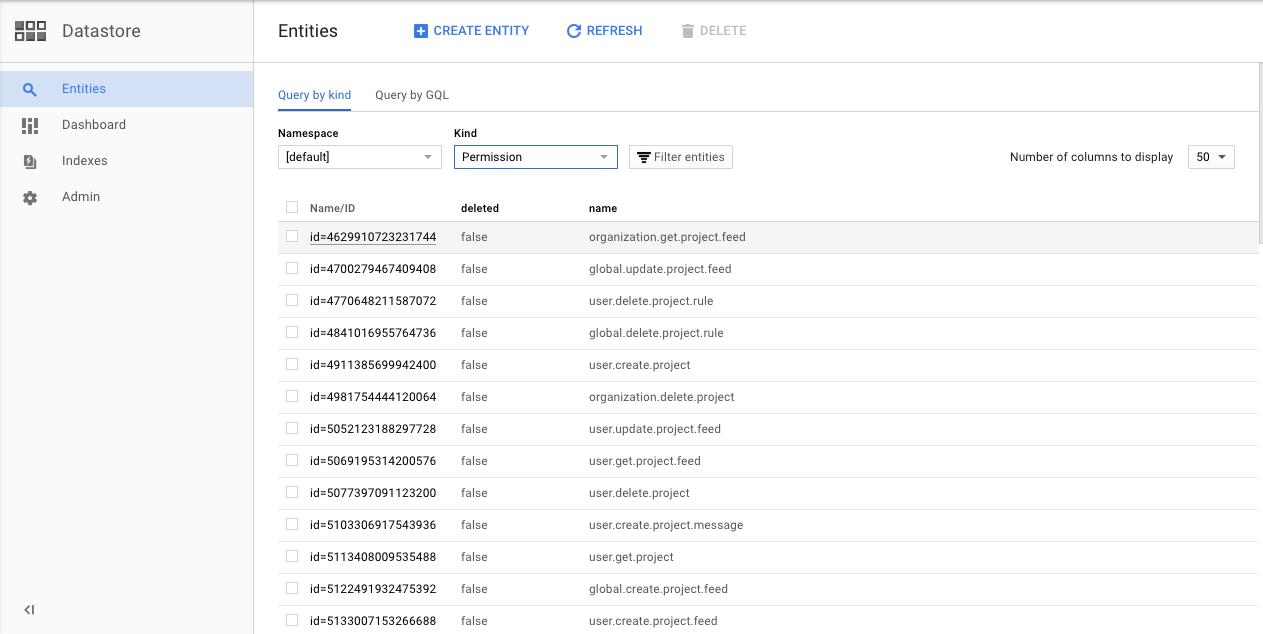
รูปที่ 3-10 Screenshot หน้า Google DataStore
สำหรับ Node.js จะมี gstore-node เป็น entities modeling Library สำหรับ Google Datastore คล้ายกับ mongoose สำหรับ object modeling สำหรับ MongoDB
ตัวอย่างการสร้าง Schema ด้วย gstore-node
const userSchema = new Schema({
  firstname: { type: 'string' },
  lastname: { type: 'string' },
  age: {type: 'number'}
});
หากต้องการ Filter หรือ Sort อย่างน้อย 2 key พร้อมกัน จะต้องทำการสร้าง Composite Index ก่อน จึงจะสามารถใช้งานได้
(https://cloud.google.com/appengine/docs/python/config/indexconfig)
ตัวอย่าง
query.filter('firstname =', 'Google').filter('size <', 400);
คำสั่งในการจัดการ index
gcloud preview datastore create-indexes ./index.yaml
gcloud preview datastore cleanup-indexes ./index.yaml
index.yaml
indexes:
- kind: User
  ancestor: no
  properties:
  - name: firstname
    direction: desc
  - name: size
ใช้งานได้เฉพาะชื่อไฟล์ index.yaml
ข้อดี
Google App Engine และ Google Compute Engine สามารถเข้าถึง Google Datastore และ Google BigQuery ได้อย่างรวดเร็ว เนื่องจาก Network ภายในของ Google
ข้อเสีย
หากติดปัญหาจะแก้เองค่อนข้างลำบากเนื่องจากกลุ่มผู้ใช้ Google Cloud Platform ไม่ได้มีมากเท่าที่ควร และ การอ่านจากคู่มือที่ให้มาเข้าใจค่อนข้างยาก